AI в тестировании сайтов уже не ограничивается записью кликов. Современные платформы генерируют сценарии из текста, восстанавливают селекторы, группируют причины падений и сравнивают интерфейс на разных браузерах.
В рейтинг вошли сервисы с самостоятельным веб-тестовым сценарием. Мы оценивали функциональное покрытие, контроль результата, интеграции с CI и прозрачность коммерческих условий.
Цены, статусы alpha или beta и способы пробного доступа проверены по официальным страницам на 12 сентября 2026 года. Если поставщик показывает только форму продаж, мы прямо указываем цену по запросу.
Выбор лучше начинать с одного критичного пользовательского пути и набора реальных браузеров. Такой пилот быстро показывает, насколько AI снижает поддержку тестов, а не просто красиво генерирует первый сценарий. В пилот стоит включить стабильный позитивный поток, намеренно сломанный селектор, визуальное смещение и сетевую ошибку. Сравнение должно учитывать не только успешную запись теста, но и диагностику падения, повторный запуск, поддержку тестовых данных и стоимость параллельного исполнения.
1. Tricentis Testim
Tricentis Testim — AI-стабилизированная платформа веб-автоматизации с low-code редактором и поддержкой CI.
Команда осваивает Tricentis Testim на сквозном процессе: записать пользовательский путь, уточнить шаги и локаторы, запустить в браузерной матрице и разобрать результат.
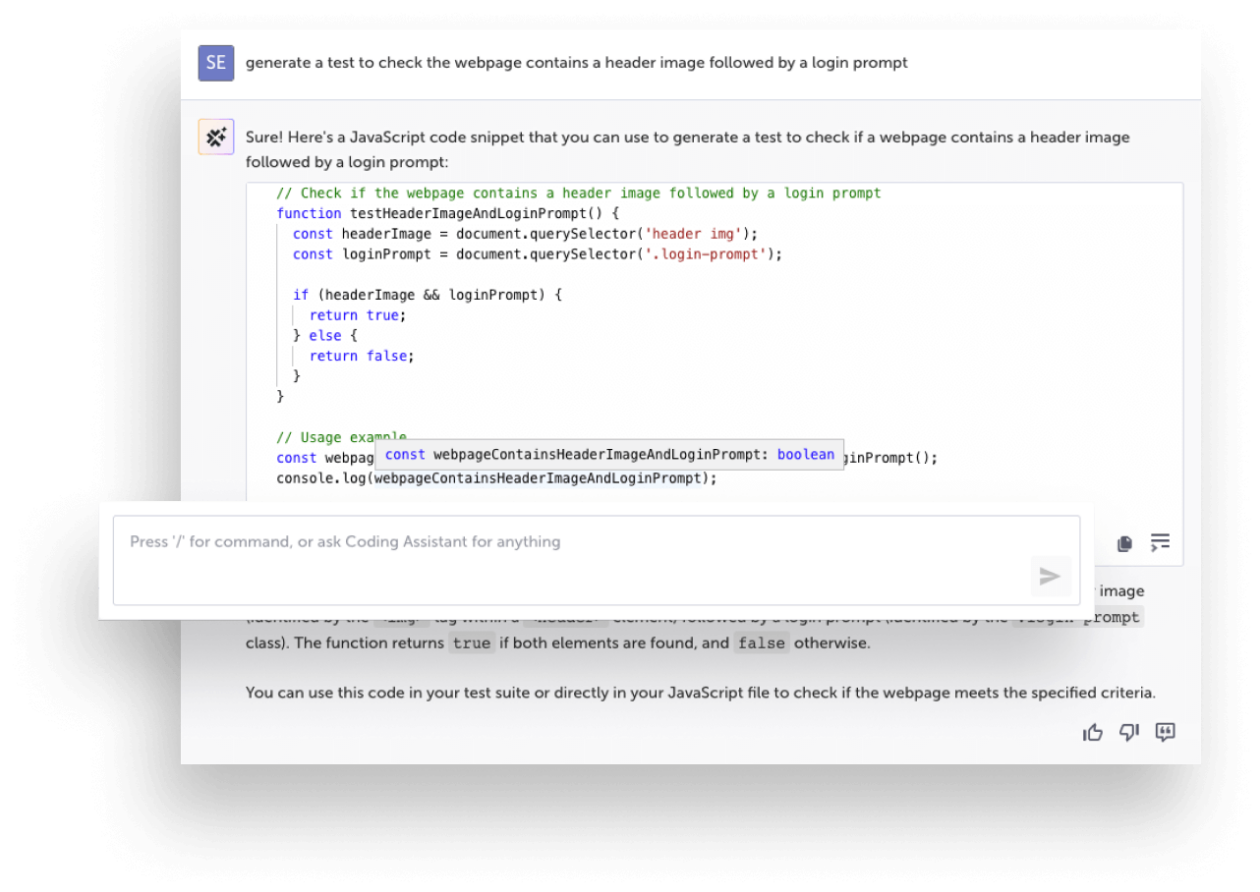
Tricentis Testim уместен там, где веб-регрессия состоит из множества записанных сценариев и интерфейс меняется от релиза к релизу. В документации описаны запись тестов, последующее редактирование и добавление шагов валидации: это позволяет править конкретную проверку, а не записывать весь сценарий заново.
Сервис стоит рассматривать QA-командам, которые ведут большой набор веб-проверок и должны запускать его в разных контурах. Testim документирует локальные прогоны, запуски на grid и в CI. Наборы, планы и labels помогают разложить регрессию по назначению, а результаты и сбои — разобрать после запуска.
Для корректного бюджета Tricentis Testim придётся учитывать ограничение: публичная длительность trial не указана, а бесплатный Community-доступ относится к Web и становится доступен после trial.
Условия оплаты Tricentis Testim зависят от выбранного направления: Web Community Free доступен после free trial, а коммерческая стоимость Web, Salesforce и Mobile рассчитывается по запросу. Для Mobile включён один параллельный запуск; дополнительные рассчитываются отдельно.
Проверку начните с записанного веб-сценария, который меняется после правки интерфейса: отредактируйте шаги, добавьте валидацию и запустите тест локально либо через CI. Затем сравните статус и причину сбоя с фактическим дефектом. Такой маршрут показывает, насколько удобно поддерживать регрессию, а не только записывать её.
Официальный сайт: https://www.testim.io/
Функционал
- AI-подготовка или поддержка веб-тестов
- Локальные, grid- и CI-запуски с просмотром статусов, результатов и причин сбоев по каждому тесту
Ключевые преимущества
- Записанный веб-тест можно отредактировать и дополнить шагами валидации после изменения интерфейса, не записывая весь сценарий заново
- Suites, plans и labels группируют тесты по назначению и упрощают управление составом регулярных регрессионных запусков
Сильные стороны
- Тесты запускаются локально, на grid и в CI, поэтому регрессию можно встроить в существующий цикл поставки
- Результаты и причины сбоев доступны для анализа, что ускоряет командный разбор неуспешного прогона после релиза
Ограничения
- Публичная длительность trial не указана; Community доступен после него только для Web и ограничен одним планом на организацию
- После записи теста могут потребоваться ручное редактирование шагов и добавление валидаций для нужных проверок проекта
Кому подходит
- QA-команды, поддерживающие крупный набор веб-регрессии и регулярно пересматривающие сценарии после изменений интерфейса
- Команды с веб-приложением, которым нужны локальные, grid- или CI-прогоны одного набора тестов
Тарифы
- Web Community Free — бесплатный Community-доступ становится доступен после free trial; публичная длительность trial не указана.
- Web — коммерческая стоимость по запросу.
- Salesforce — коммерческая стоимость по запросу.
- Mobile — коммерческая стоимость по запросу; включён 1 параллельный запуск, дополнительные параллельные запуски рассчитываются по запросу.
2. mabl
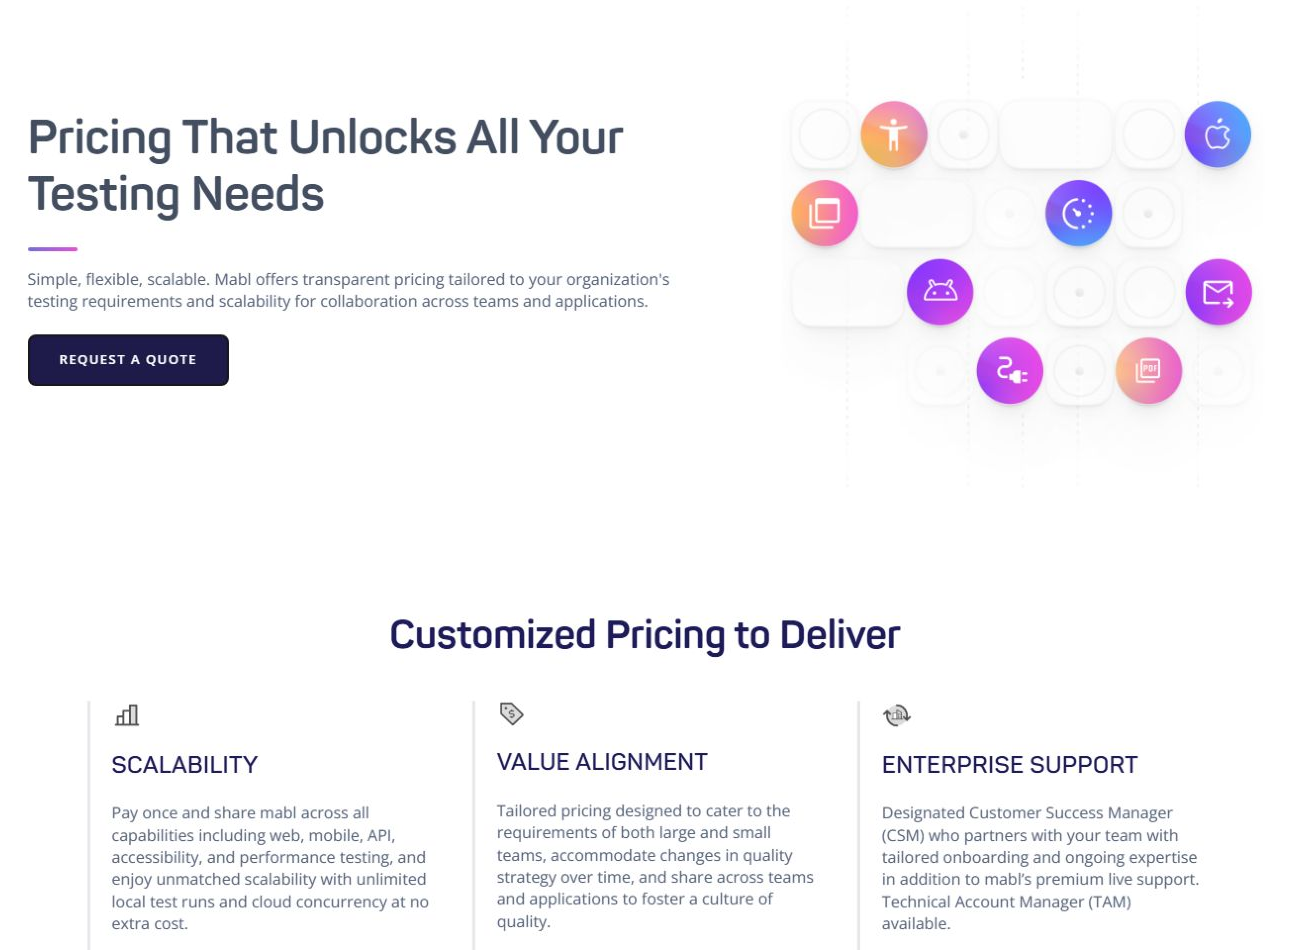
mabl — единая AI-платформа для web, API и mobile testing с анализом качества.
mabl рассчитан на end-to-end проверку продукта, где один пользовательский путь проходит через веб, мобильное приложение и API. Платформа заявляет покрытие iOS, Android и API, а также импорт коллекций Postman. Для команд это способ держать связанные проверки в одном тестовом контуре, а не разбирать канал за каналом.
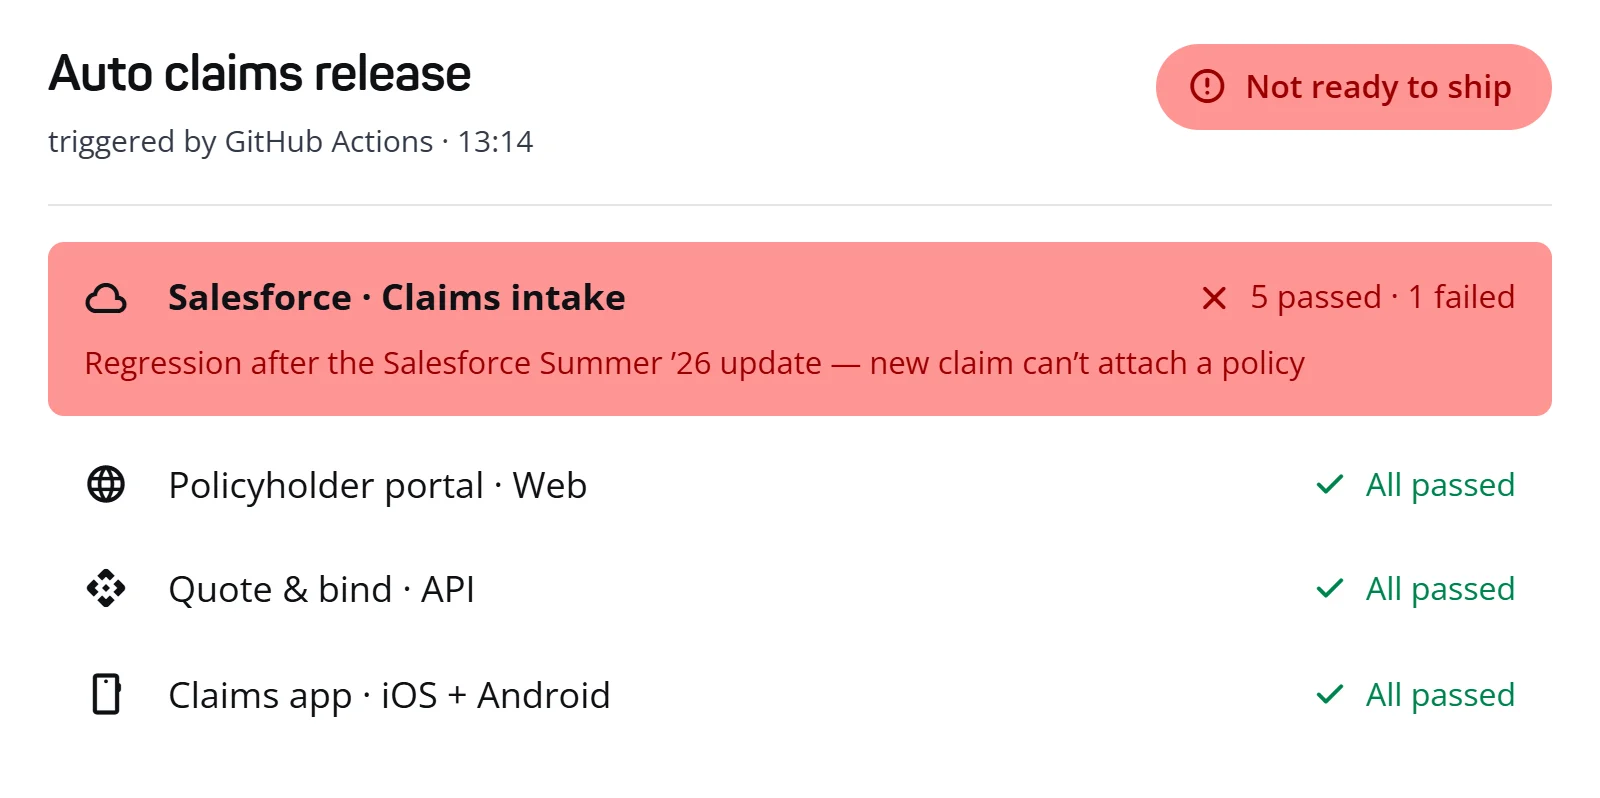
Рабочий сценарий в mabl можно построить вокруг одного заказа или регистрации: проверить шаги в веб-интерфейсе, связанный вызов API и продолжение пути на мобильном устройстве. Для API доступны собственные проверки и импорт коллекций Postman. После прогона платформа сохраняет действия агента и теста до ветки и пошаговых логов.
mabl подходит продуктовым QA-командам с непрерывной поставкой, если им нужно видеть не только итог прогона, но и его связь с требованиями перед релизом. Платформа описывает requirements-to-results traceability как доказательство готовности выпуска. Это особенно полезно при общем контроле веба, мобильных клиентов и API.
Публичные ориентиры по стоимости mabl следующие: 14-дневный trial; коммерческий объём от 500 cloud credits в месяц, цена по запросу.
Перед масштабированием mabl команда должна проверить следующее: облачные прогоны расходуют credits, хотя local и CI runs заявлены unlimited.
В mabl стоит оценивать не отдельный экран отчёта, а разбор конкретного сквозного сбоя. Запустите путь через веб и API либо мобильный клиент, затем откройте зафиксированные действия, ветку и пошаговые логи. Если по ним команда связывает результат с требованием и причиной сбоя, платформа даст полезные доказательства для релизного решения.
Официальный сайт: https://www.mabl.com/
Функционал
- AI-подготовка или поддержка веб-тестов
- End-to-end тесты для веба, iOS, Android и API, включая импорт коллекций Postman в API-проверки проекта
Ключевые преимущества
- Покрывает сложные пользовательские потоки через веб, мобильные приложения и API в рамках одного тестового контура
- Фиксирует действия агента и теста до ветки и пошаговых логов, упрощая расследование результата
Сильные стороны
- Связывает требования с результатами тестирования, формируя доказательства для команды перед выпуском релиза
- Подключается к GitHub, GitLab, Jenkins, Jira и Slack, передавая статусы тестов в рабочие инструменты команды
Ограничения
- Облачные запуски расходуют credits, поэтому их объём нужно сопоставлять с доступным месячным лимитом при регулярной регрессии
- Импорт API-сценариев ориентирован на коллекции Postman, поэтому используемый командой формат стоит сопоставить с этим способом входа
Кому подходит
- Продуктовые QA-команды с непрерывной поставкой, которым нужно связывать требования, прогоны и доказательства готовности релиза
- Команды, тестирующие единый пользовательский путь через веб, мобильное приложение и API в релизном цикле
Тарифы
- 14-дневный trial
- коммерческий объём от 500 cloud credits в месяц, цена по запросу
3. LambdaTest KaneAI
LambdaTest KaneAI — генеративный помощник для создания и редактирования тестов естественным языком в облаке LambdaTest.
Сценарий в LambdaTest KaneAI начинается с текстового описания: сервис формирует шаги, позволяет уточнить их в диалоге и выполнить на нужных окружениях.
KaneAI подходит команде, которая описывает пользовательский путь обычным языком и хочет получить не только черновик, но и управляемый сценарий. Агент планирует, пишет и развивает end-to-end тесты; перед запуском ревьюер может скорректировать подготовленный план. Это сохраняет контроль там, где формулировка требования неоднозначна.
В веб-регрессии KaneAI позволяет собрать связанные проверки интерфейса, API, сетевых ответов и доступности в одном потоке. Например, после оформления заказа команда может сопоставить экран с эталоном на пиксельном уровне и одновременно отследить битый API, медленный endpoint или неудачную передачу payload. Такой подход помогает не разрывать разбор одной ошибки между несколькими проверками.
Граница автоматизации заметна в работе с pull request: KaneAI умеет прочитать diff GitHub, сгенерировать и выполнить тесты, а затем оставить результаты в обсуждении. Однако этот сценарий в документации помечен как Beta. Его стоит рассматривать как возможность для проверки процесса, а не как безусловную опору для каждого изменения.
Практический маршрут можно построить от Jira-задачи или PRD: KaneAI создаёт структурированные тест-кейсы, после чего ревьюер правит план до запуска. Для сценария оформления заказа затем уместно добавить UI-, API- и сетевые проверки. При изменении процесса команда сравнит новую версию теста с прежней или откатит её.
При регулярных изменениях сайта ценность KaneAI связана не с разовым созданием теста, а с его дальнейшей правкой. Сервис поддерживает версии, адаптацию к окружениям и повторно используемые модули; изменения можно сравнивать и откатывать. Это полезно, когда один пользовательский путь меняется вместе с интерфейсом и интеграциями.
Официальный сайт: https://www.lambdatest.com/kane-ai
Функционал
- AI-подготовка или поддержка веб-тестов
- Создание и развитие end-to-end тестов по естественно-языковому описанию с правкой плана ревьюером перед непосредственным выполнением.
Ключевые преимущества
- Единый поток для веб-интерфейса, API, сети, доступности и пиксельного сравнения экранов при поиске визуальных ошибок.
- Преобразование Jira-задач, PRD, PDF, скриншотов и таблиц в структурированные тест-кейсы для дальнейшего просмотра командой.
Сильные стороны
- Версии сценариев, сравнение изменений, откат и адаптация к окружениям помогают поддерживать тесты при обновлении сайта.
- Повторно используемые модули позволяют собирать общие шаги в нескольких end-to-end проверках без их повторного описания.
Ограничения
- Проверка GitHub pull request отмечена как Beta, поэтому её стабильность и применимость нужно отдельно оценивать для процесса команды.
- Подготовленный агентом план можно изменить до выполнения; без такой проверки неоднозначные требования могут остаться неверно истолкованными.
Кому подходит
- Веб-команды, которым нужно связывать проверки интерфейса, API, сети, доступности и визуальных изменений в одном сценарии.
- Проекты с часто меняющимися пользовательскими потоками, где полезны версии тестов, модули и адаптация к окружению.
Тарифы
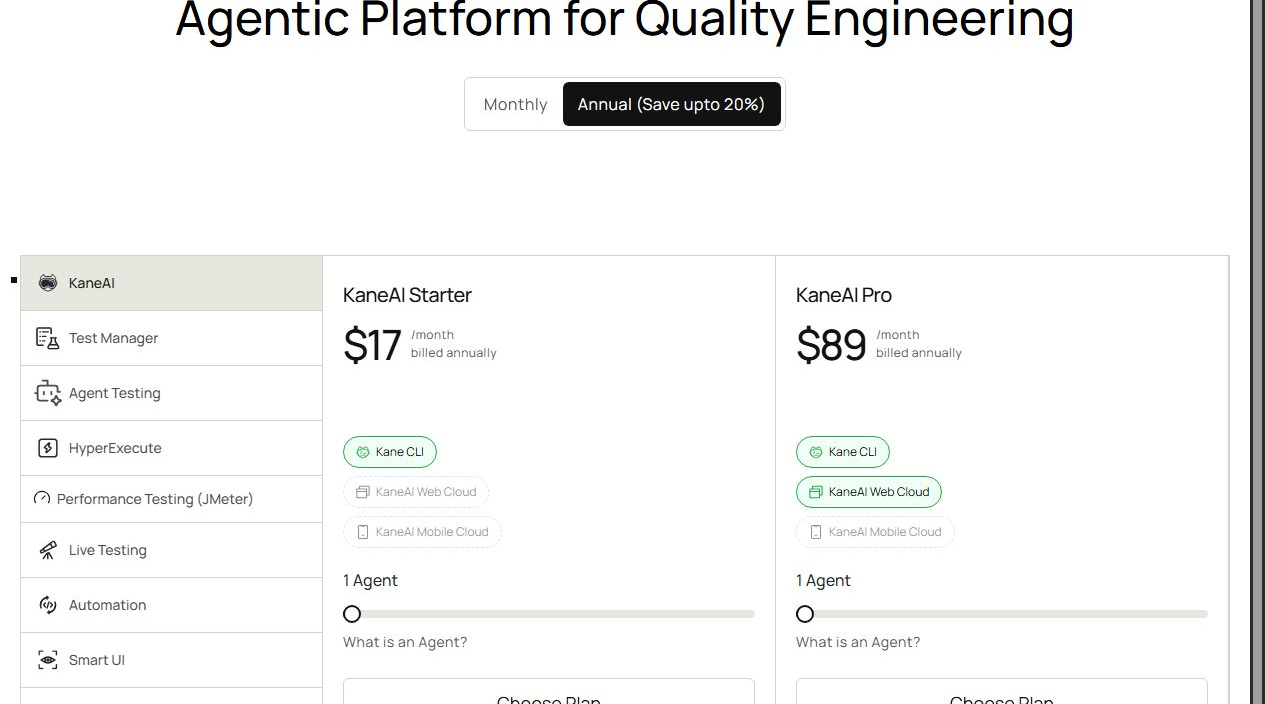
- пробный доступ зависит от аккаунта
- коммерческая стоимость — по плану или предложению
4. BrowserStack AI Agents
BrowserStack AI Agents — набор агентов для генерации, ремонта и анализа low-code тестов на инфраструктуре BrowserStack.
По своему сценарию BrowserStack AI Agents рассчитан на определённый тип команды: QA-команды, уже использующие BrowserStack.
Работа с Agentic Testing начинается с требования, URL или описания нужной проверки на естественном языке. AI формирует тест-кейсы, записывает и валидирует их, а пользователь может уточнить получившийся сценарий в чате до автоматизации. Во время выполнения агент управляет реальным облачным браузером, а не только моделирует последовательность действий.
Для функционального тестирования сайта Agentic Testing полезен, когда тест надо быстро связать с описанным требованием или исследованием URL, а затем уточнить без переписывания сценария с нуля. После изменения приложения AI может восстанавливать тест. Документация отдельно оговаривает: adaptive healing не должен намеренно скрывать настоящее расхождение с ожидаемым результатом.
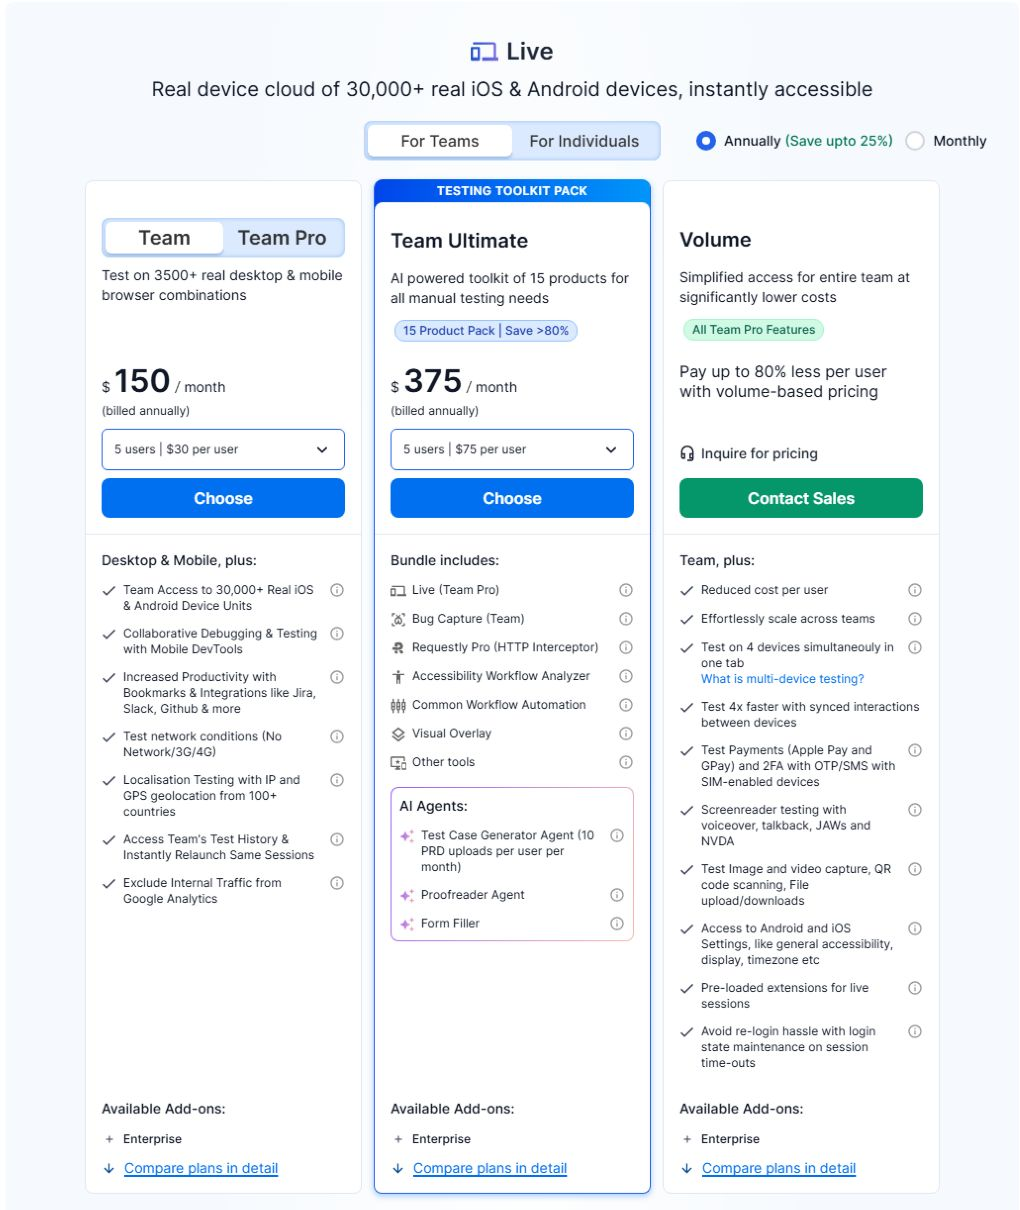
Перед пилотом бюджет BrowserStack AI Agents стоит сверить с этой сеткой: Testing Toolkit Team Ultimate — $375 в месяц годом для пяти пользователей; другие редакции считаются отдельно.
Статус Alpha означает, что доступ к функции может меняться; продукт относится к Low Code Automation BrowserStack. Его следует рассматривать как отдельный маршрут автоматизации, а не как стандартную возможность всей платформы. Такая оговорка существенна для команд, которые строят на инструменте длительный регрессионный процесс.
Главная граница здесь не в браузерном запуске, а в зрелости функции. Agentic Testing всё ещё Alpha, и BrowserStack предупреждает, что доступ может измениться. Сгенерированный сценарий можно уточнить в чате до автоматизации, однако соответствие бизнес-ожиданию всё равно определяет команда, формулирующая требование.
Официальный сайт: https://www.browserstack.com/low-code-automation/ai-agents
Функционал
- AI-подготовка или поддержка веб-тестов
- Выполнение сгенерированных проверок в реальном облачном браузере после записи, валидации и уточнения сценария через чат.
Ключевые преимущества
- Требования и исследование URL служат исходными материалами для черновика теста, который можно доработать диалогом.
- AI может восстанавливать тест после изменения приложения, чтобы поддерживать проверку ожидаемого пользовательского пути в актуальном виде.
Сильные стороны
- Агент управляет реальным облачным браузером во время автоматизации, поэтому сценарий проходит фактические действия в браузерной среде.
- Adaptive healing не предназначен для намеренного скрытия истинного несовпадения с ожидаемым результатом, согласно документации BrowserStack.
Ограничения
- Функция имеет статус Alpha, а доступ к ней может меняться по мере развития Agentic Testing.
- Автоматическое healing не заменяет точную формулировку ожидаемого результата: система не должна маскировать настоящее падение проверки.
Кому подходит
- QA-команды, использующие Low Code Automation BrowserStack и желающие формулировать веб-проверки на естественном языке без скриптов.
- Веб-продукты, где требования или исследование URL можно превратить в черновик функционального теста и уточнить в чате.
Тарифы
- Testing Toolkit Team Ultimate — $375 в месяц годом для пяти пользователей
- другие редакции считаются отдельно
5. Functionize Studio
Functionize Studio — AI-first среда, которая создаёт тесты, исполняет их и помогает разбирать падения.
В задаче веб-тестирования у Functionize Studio есть чёткая специализация: даёт самостоятельный бесплатный уровень и понятные кредитные пакеты.
Поставщик описывает Functionize Studio как агентную платформу качества и независимую проверку рядом с агентами, которые пишут код. Для веб-команды это не замена разработке тестовой стратегии, а отдельный способ проверить ожидаемое поведение приложения в рамках регулярной регрессии команды.
Рабочий поток начинается с описания ожидаемого поведения обычным языком в чатовом интерфейсе. Studio строит по нему тест, запускает его в разных браузерах и при каждом прогоне читает работающее приложение. Если интерфейс сместился, платформа, по описанию Functionize, ищет элемент по его назначению, а не по хрупкому селектору.
По описанию продукта Studio логично рассматривать QA-командам, которые уже получают изменения от кодовых агентов и хотят отдельно проверять пользовательские веб-потоки. Такой выбор особенно оправдан, когда тест нужно собрать из текстового описания, а дальнейшую поддержку сценария связывают с изменениями в интерфейсе.
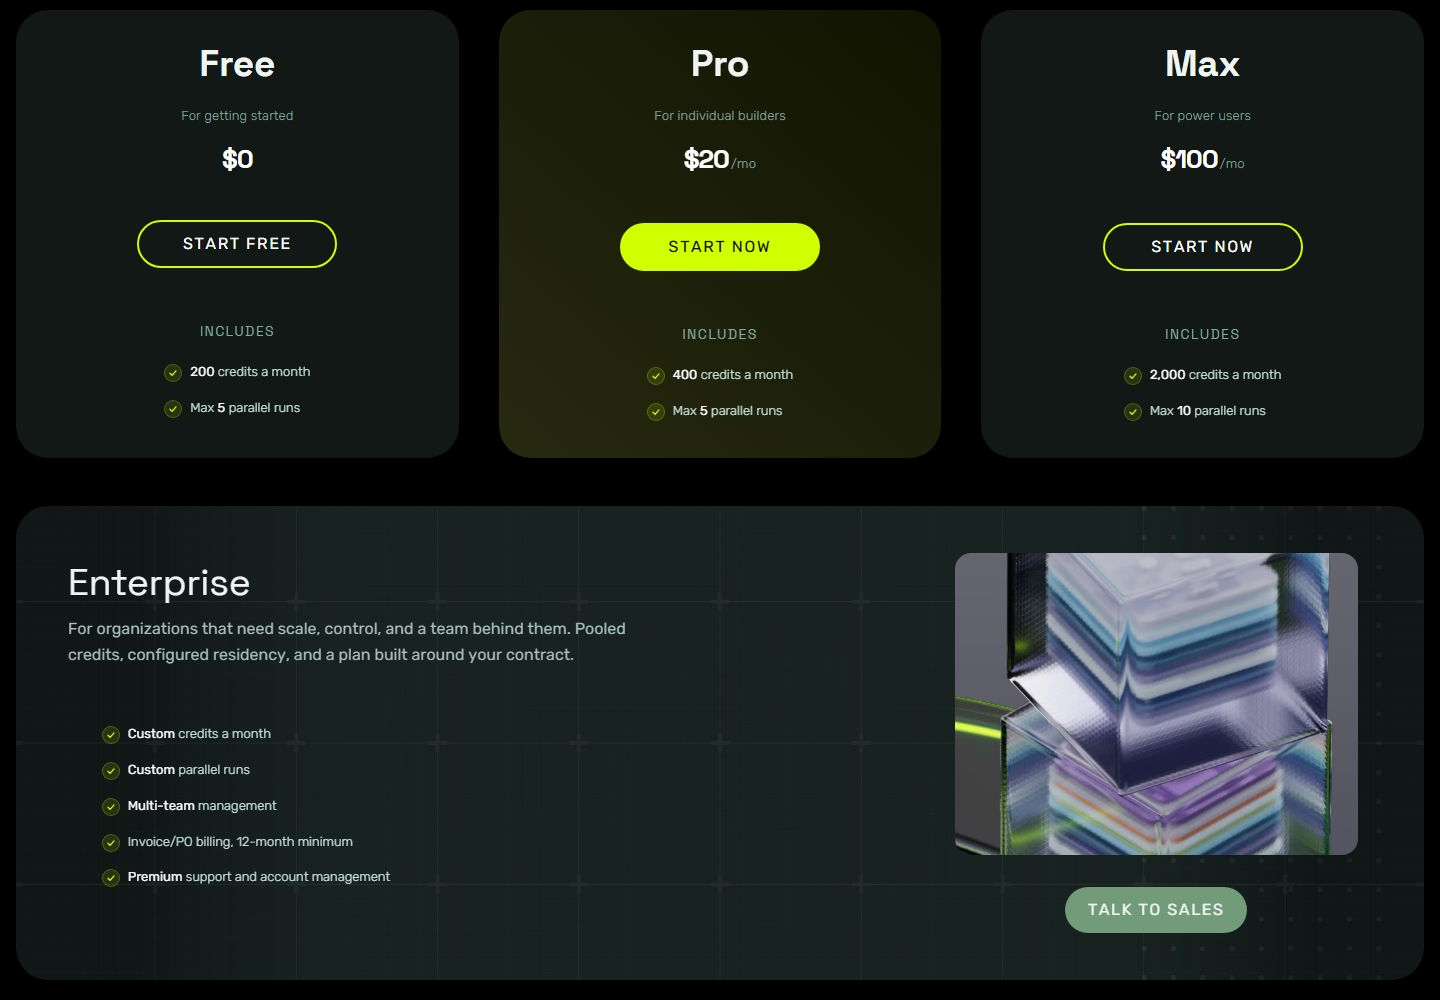
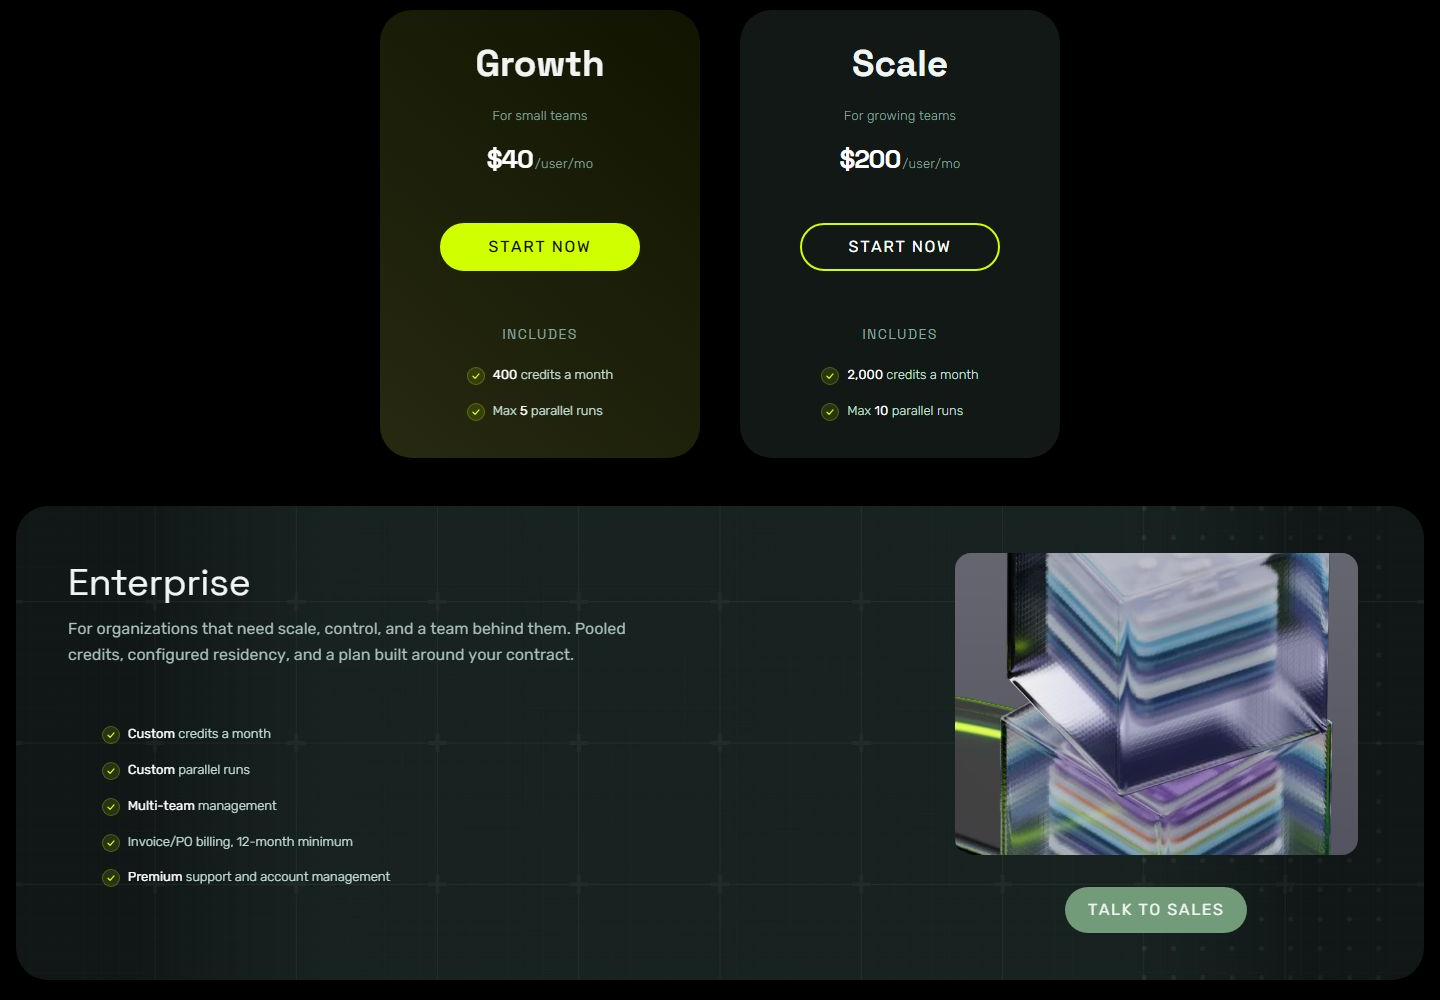
По подписке Functionize Studio действуют такие ориентиры: Free — $0 в месяц с 200 credits и максимум 5 параллельными запусками; Pro — $20 с 400 credits и максимум 5 запусками; Max — $100 с 2 000 credits и максимум 10 запусками; командные Growth — $40 за пользователя с 400 credits и Scale — $200 за пользователя с 2 000 credits и максимум 10 запусками.
При сравнении с другими AI-платформами дайте Studio один реальный браузерный путь: например, вход в личный кабинет и смену данных профиля. Сначала опишите ожидаемый результат словами, затем посмотрите, как сервис строит и запускает проверку в браузерах. Отдельно оцените, сохраняет ли он устойчивость после изменения расположения элементов.
Официальный сайт: https://www.functionize.com/
Функционал
- AI-подготовка или поддержка веб-тестов
- Запускает созданные проверки в разных браузерах и при каждом прогоне читает работающее приложение для поиска изменений.
Ключевые преимущества
- Позволяет формулировать ожидаемое поведение обычным языком в чатовой модели взаимодействия, а затем строить по описанию тест.
- Сопровождает тесты при изменениях приложения, разрешая элементы по назначению вместо привязки к хрупким селекторам.
Сильные стороны
- Документирована работа через MCP с Cursor, Windsurf, Claude Code и другими совместимыми MCP-клиентами для интеграции.
- Позиционируется как независимый контроль ожидаемого поведения рядом с агентами, которые пишут код для приложения.
Ограничения
- Модель без хрупких селекторов меняет привычную диагностику падений: команде нужно отдельно оценить её на собственных сценариях.
- Заявленную поддержку тестов после изменений интерфейса следует проверять на реальных веб-потоках и используемых браузерах.
Кому подходит
- QA-командам, использующим кодовых агентов и нуждающимся в отдельной проверке пользовательского поведения веб-приложения перед релизной регрессией.
- Проектам с регулярной браузерной регрессией, где сценарии удобно задавать текстовым описанием ожидаемого поведения пользователя.
Тарифы
- Free — $0 в месяц: 200 credits в месяц и до 5 параллельных запусков.
- Pro — $20 в месяц: 400 credits в месяц и до 5 параллельных запусков.
- Max — $100 в месяц: 2 000 credits в месяц и до 10 параллельных запусков.
- Growth — $40 за пользователя в месяц: 400 credits в месяц и до 5 параллельных запусков.
- Scale — $200 за пользователя в месяц: 2 000 credits в месяц и до 10 параллельных запусков.
- Enterprise — индивидуальные объём credits и число параллельных запусков, общий пул credits, управление несколькими командами, настройка резидентности данных, премиальная поддержка, оплата по счёту или PO и минимум 12 месяцев по договору.
- Акция запуска — скидка 50% на первые два месяца и 1 000 бонусных credits; это временное предложение, а не постоянная цена тарифа.
6. Autify Aximo
Autify Aximo — AI-based no-code автоматизация веб-тестов с новой кредитной линейкой Aximo.
После стартового запроса Autify Aximo оставляет работу внутри продукта: создать сценарий без кода, запустить его и позволить системе адаптировать шаги к изменениям UI.
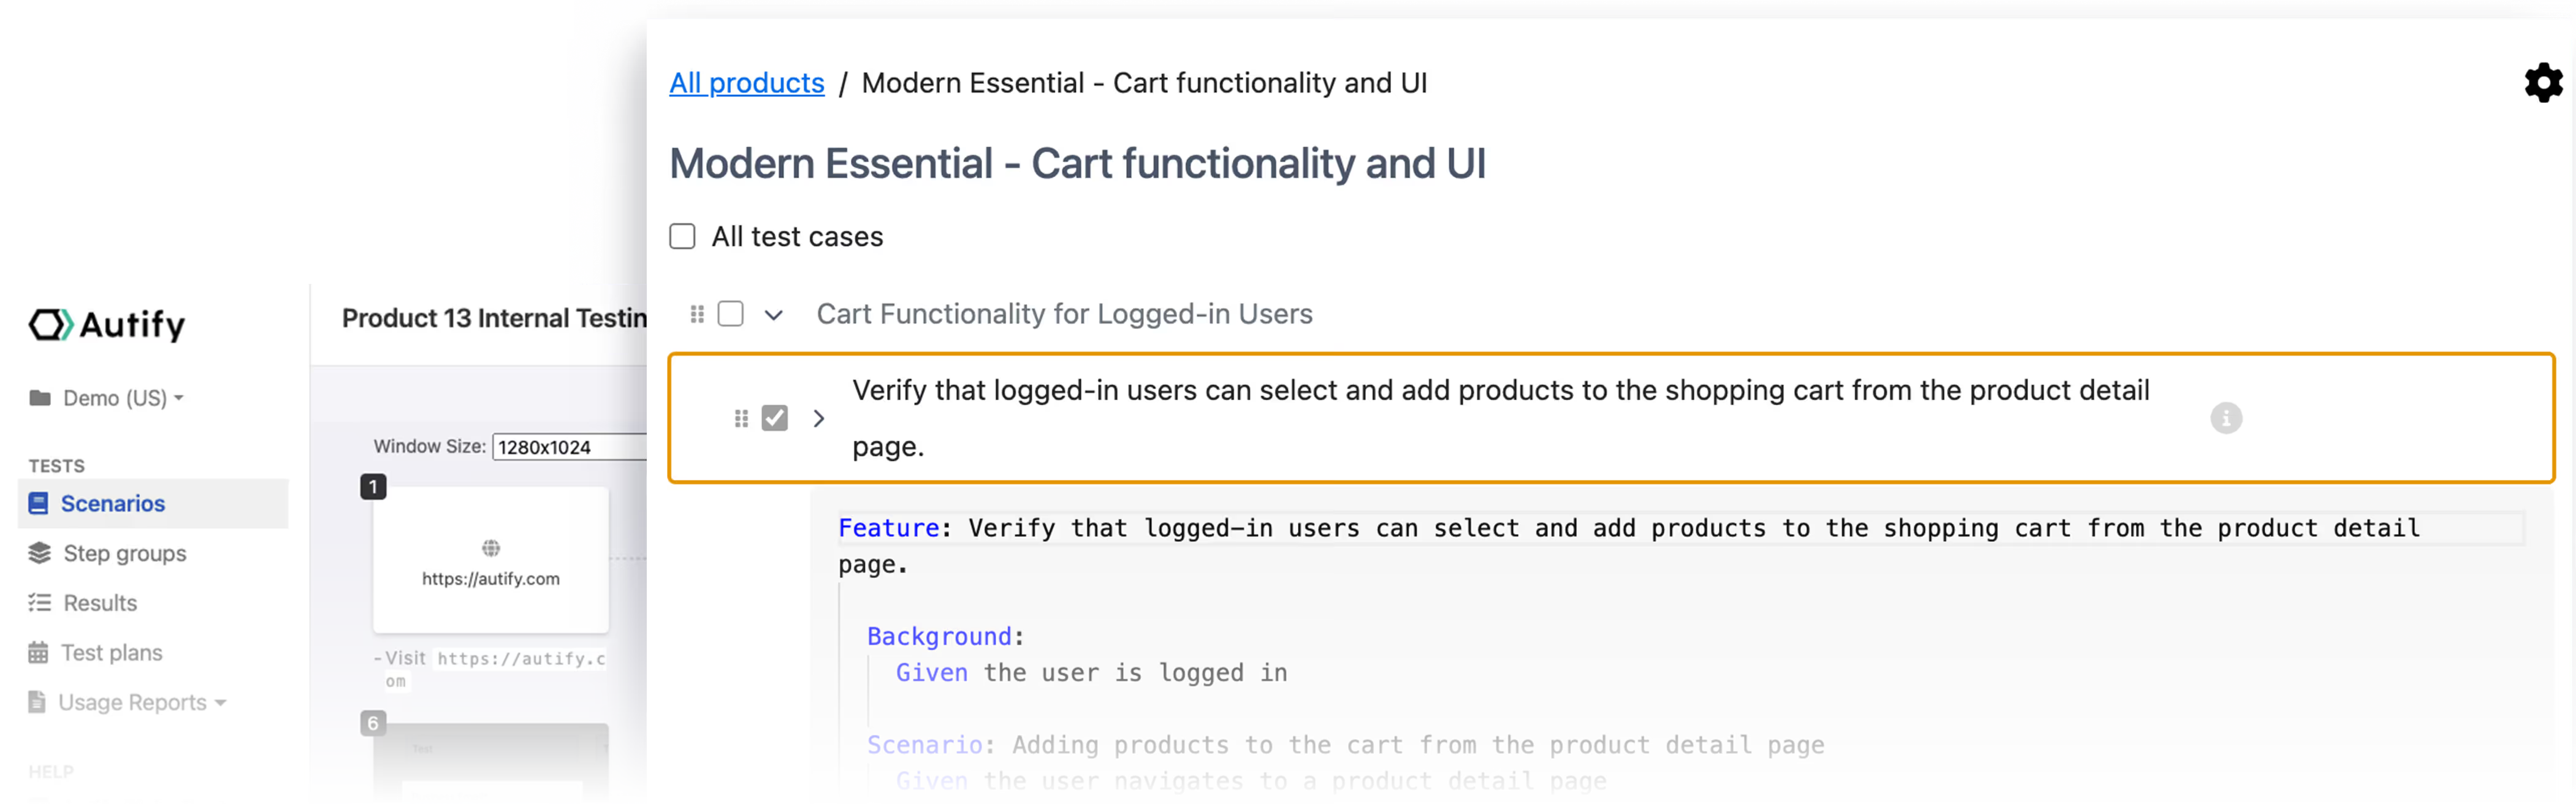
Aximo построен вокруг другого принципа: поставщик заявляет, что агент не опирается на скрипты и селекторы. Сценарий задают естественным языком, а во время выполнения он использует визуальное распознавание и проходит приложение как пользователь. Это меняет привычный подход к подготовке автотестов и требует оценивать продукт на собственном интерфейсе.
По заявленному охвату Aximo подходит командам, которым нужно проверять один пользовательский путь не только в вебе, но и на мобильных или desktop-приложениях. Это редакционный вывод из заявленной поддержки iOS, Android, Windows и macOS; фактическую применимость к конкретному стеку стоит отделять от широты списка платформ.
Практическая ценность Aximo в end-to-end сценарии: агент получает задачу обычным языком, ориентируется по визуальным признакам, проходит шаги в приложении и сверяет итог с ожидаемым результатом. После завершения сценария продукт сообщает результат теста, поэтому его можно сопоставить с тем, что должна увидеть команда QA.
Сравнивать Aximo с браузерными AI-инструментами лучше на одном завершённом веб-сценарии, например оформлении заказа с проверкой финального экрана. Здесь видно, как агент интерпретирует текстовую задачу, перемещается по интерфейсу и валидирует ожидаемый итог. Если проекту нужен только браузер, отдельно взвесьте, нужна ли заявленная мультиплатформенность.
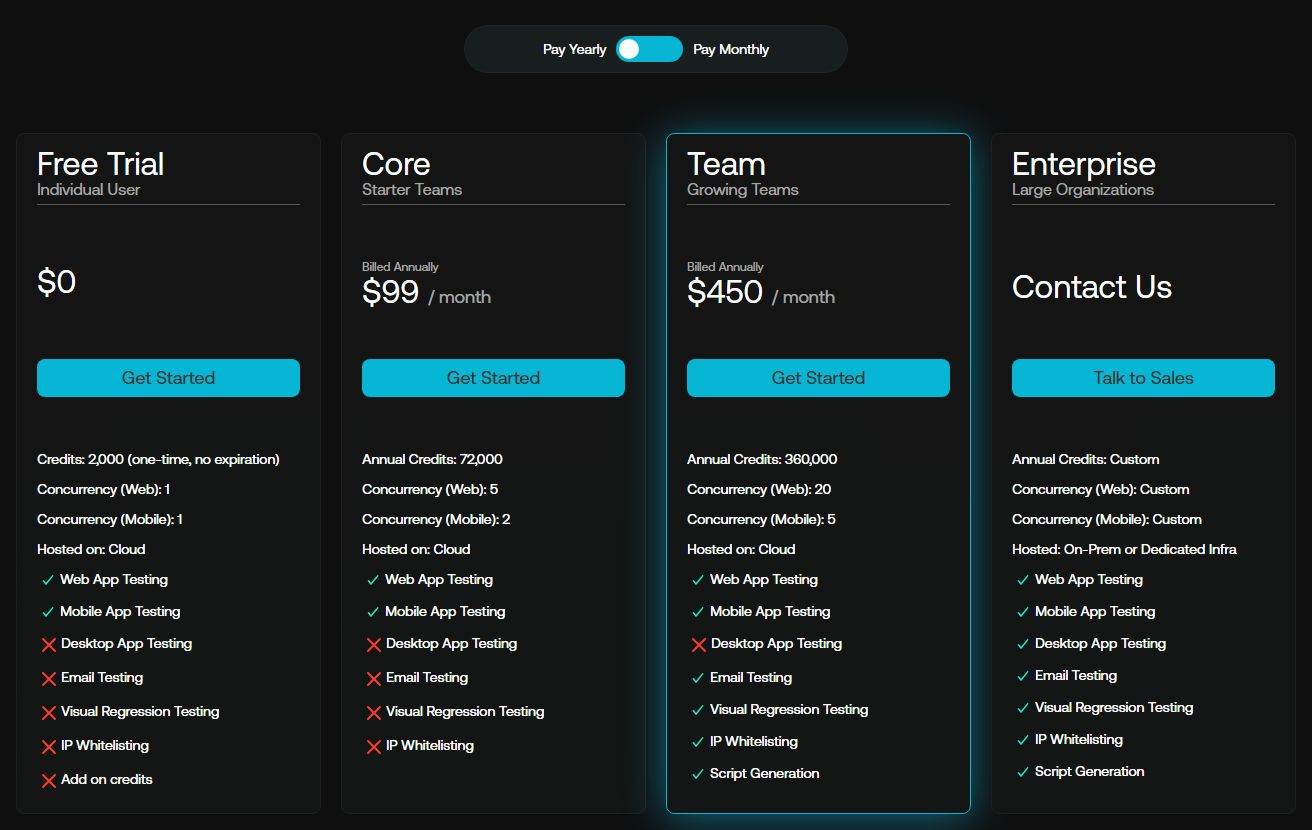
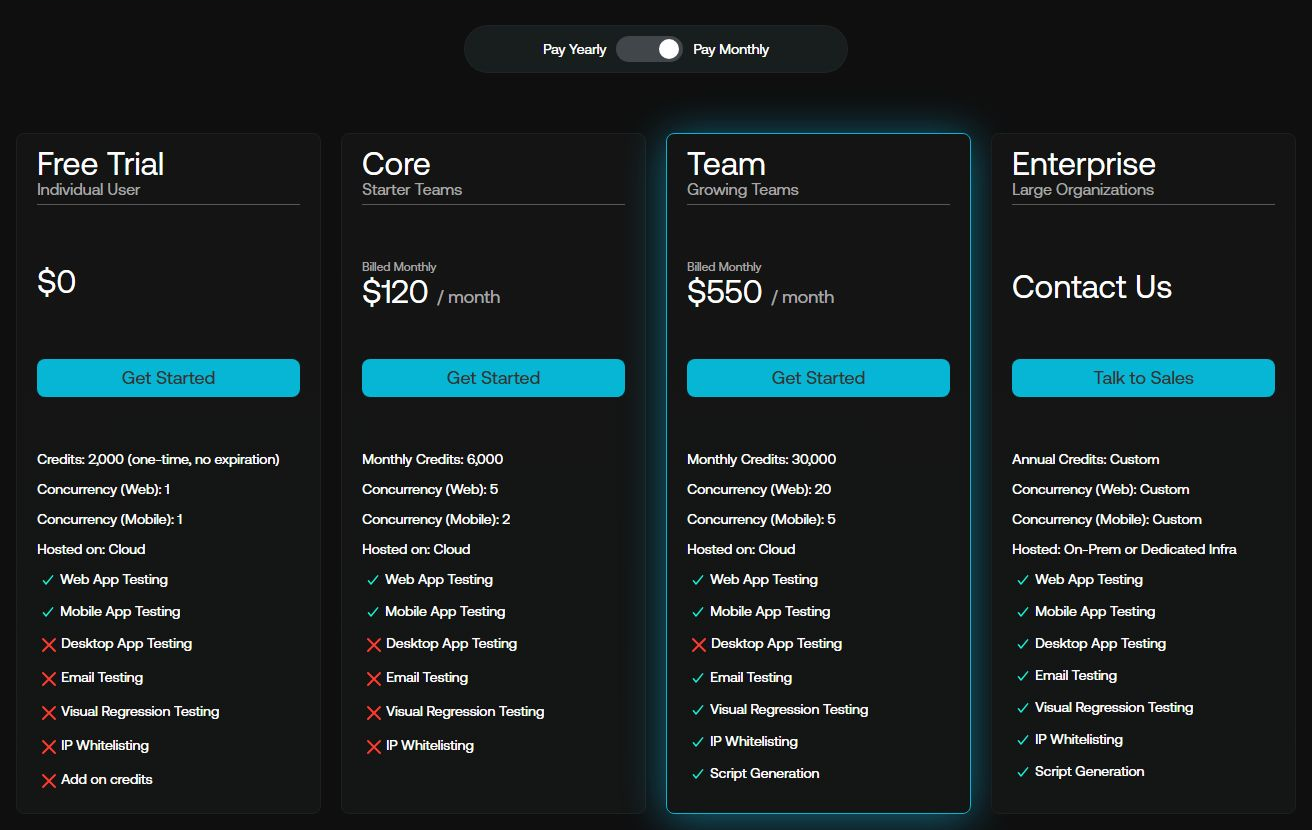
Тарифная лестница Autify Aximo начинается со следующих условий: Free Trial даёт $0 и 2 000 разовых credits без срока действия; Core стоит $120 в месяц или $99 в месяц при годовой оплате; Team — $550 в месяц или $450 в месяц при годовой оплате; Enterprise рассчитывается индивидуально. У Core предусмотрено 6 000 credits в месяц либо 72 000 в год, у Team — 30 000 в месяц либо 360 000 в год.
Официальный сайт: https://autify.com/
Функционал
- AI-подготовка или поддержка веб-тестов
- Проходит пользовательский сценарий end-to-end, применяет визуальное распознавание и после завершения показывает понятный результат теста.
Ключевые преимущества
- Принимает сценарий на естественном языке, не требуя готовить скрипты или устойчивые селекторы для запуска проверки.
- Навигирует приложение как пользователь и сверяет получившийся итог с ожидаемым результатом, заданным в сценарии.
Сильные стороны
- Заявляет охват веб-, мобильных и desktop-приложений, включая iOS, Android, Windows и macOS для разных тестовых контуров.
- Поддерживает взаимодействия на уровне операционной системы, расширяя проверку за пределы одного браузерного интерфейса приложения.
Ограничения
- Отсутствие опоры на скрипты и селекторы меняет привычный способ проектирования автотестов и разбора их сбоев.
- Для чисто браузерной регрессии заявленная поддержка мобильных и desktop-платформ может оказаться избыточной для конкретной команды.
Кому подходит
- Командам, которым нужно задавать end-to-end проверки естественным языком и проходить приложение по пользовательскому сценарию.
- Проектам с пользовательскими потоками на вебе, мобильных устройствах и desktop-системах в рамках одного тестового контура.
Тарифы
- Free Trial — $0: 2 000 разовых credits без срока действия, по одному одновременному запуску для Web и Mobile, облачное размещение.
- Core — $120 в месяц при помесячной оплате: 6 000 credits в месяц, до 5 одновременных запусков Web и до 2 Mobile. При годовой оплате — $99 в месяц и 72 000 credits в год. Desktop App Testing, Email Testing, Visual Regression Testing, IP Whitelisting и add-on credits в тариф не входят.
- Team — $550 в месяц при помесячной оплате: 30 000 credits в месяц, до 20 одновременных запусков Web и до 5 Mobile. При годовой оплате — $450 в месяц и 360 000 credits в год; доступны Email Testing, Visual Regression Testing, IP Whitelisting, Script Generation и add-on credits, но не Desktop App Testing.
- Enterprise — стоимость по запросу: индивидуальные годовые credits и лимиты одновременных запусков, выделенная инфраструктура или on-premises, Desktop App Testing.
7. Virtuoso QA
Virtuoso QA — платформа natural-language тестирования с self-healing и визуальными проверками.
По аудитории Virtuoso QA не пытается быть решением для всех: корпоративные QA-команды с участием бизнес-аналитиков.
Virtuoso QA подходит команде, которая хочет описать путь посетителя сайта без низкоуровневого сценария: например, вход, поиск товара и оформление заказа. В документации такие проверки собираются из goals и journeys, а journey запускается как job. Это связывает текст сценария с повторяемым end-to-end прогоном.
После неуспешного job не приходится ограничиваться статусом ошибки. Virtuoso документирует execution reports и root-cause analysis: в разборе может быть доступна страница в момент сбоя, сетевые запросы и скриншоты из разных браузеров. Для визуальной и функциональной регрессии это даёт материал, чтобы отделить дефект интерфейса от проблемы шага или окружения.
У пилота Virtuoso QA должен быть заранее задан критерий остановки: публичной цены и постоянного free-плана нет, оценка начинается с sales demo.
Бюджет на Virtuoso QA можно прикинуть по опубликованным уровням: доступна персональная демонстрация; коммерческая цена по запросу.
Для отбора Virtuoso QA на задачу веб-регрессии полезно взять один изменчивый пользовательский путь и оформить его как goal с journeys. Затем стоит посмотреть, насколько self-healing и подсказки выбора элементов сохраняют понятность сценария после правок интерфейса, а отчёт помогает разобрать конкретный сбой. Это редакционный критерий выбора, не гарантия автономной поддержки.
Официальный сайт: https://www.virtuoso.qa/
Функционал
- AI-подготовка или поддержка веб-тестов
- Запуск journeys как jobs с execution reports для каждого прогона пользовательского пути сайта и последующего разбора
Ключевые преимущества
- Синтаксис на естественном языке связывает цели проверки с journeys, понятными участникам QA- и продуктового процесса
- Self-healing и подсказки по выбору элементов помогают переживать изменения локаторов без полной переписи каждого шага
Сильные стороны
- Отдельно документированы интеграция CI/CD и data-driven testing для регулярных прогонов с разными наборами данных
- Root-cause analysis объединяет страницу сбоя, сетевые запросы и cross-browser screenshots для разбора выполнения job
Ограничения
- публичной цены и постоянного free-плана нет, оценка начинается с sales demo
- Self-healing требует проверки: после изменения интерфейса нужно убедиться, что найден именно нужный элемент
Кому подходит
- Корпоративные QA-команды, где аналитики описывают пользовательские journeys, а инженеры встраивают регулярные прогоны в CI/CD
- Сайты с регулярной регрессией, для которых важен разбор сбоев по странице, сетевым запросам и скриншотам
Тарифы
- доступна персональная демонстрация
- коммерческая цена по запросу
8. testRigor
testRigor — сервис end-to-end тестов на plain English, ориентированный на проверку поведения пользователя.
Среди решений для веб-тестирования testRigor отличается характером результата: делает тесты читаемыми для неавтоматизаторов.
В testRigor веб-проверку можно записать на plain English: описать действие пользователя и ожидаемый результат, затем использовать этот текст как сценарий. Документация отдельно относит к продукту generative-AI testing, no-code/codeless testing и AI-based self-healing. Такой формат удобен для обсуждения пользовательского пути сайта между QA, аналитиками и продуктовой командой.
У testRigor есть публичные тестовые материалы и private workspaces — документация описывает их как разные понятия. Для проверки сайта с авторизацией, заказами или персональными данными это означает, что режим рабочего пространства нужно определить до переноса реальных сценариев. Само наличие публичных материалов не говорит, какой доступ будет настроен в конкретном проекте.
Платформа выглядит уместной для QA, аналитиков и продуктовых команд, которые хотят согласовывать проверки сайта на понятном языке, а не только в коде. При этом testRigor охватывает не один веб: в документации перечислены mobile, desktop, mainframe и accessibility testing. Для рейтинга веб-платформ это дополнительный контекст, а не преимущество для каждого проекта.
На маршруте регистрации, поиска и оформления заказа testRigor ценен не самим текстовым синтаксисом, а тем, что его можно обсуждать до запуска теста. После изменения страницы self-healing всё равно стоит сопоставить с ожидаемым действием пользователя. А разделение публичных материалов и private workspaces требует заранее выбрать режим для рабочих сценариев.
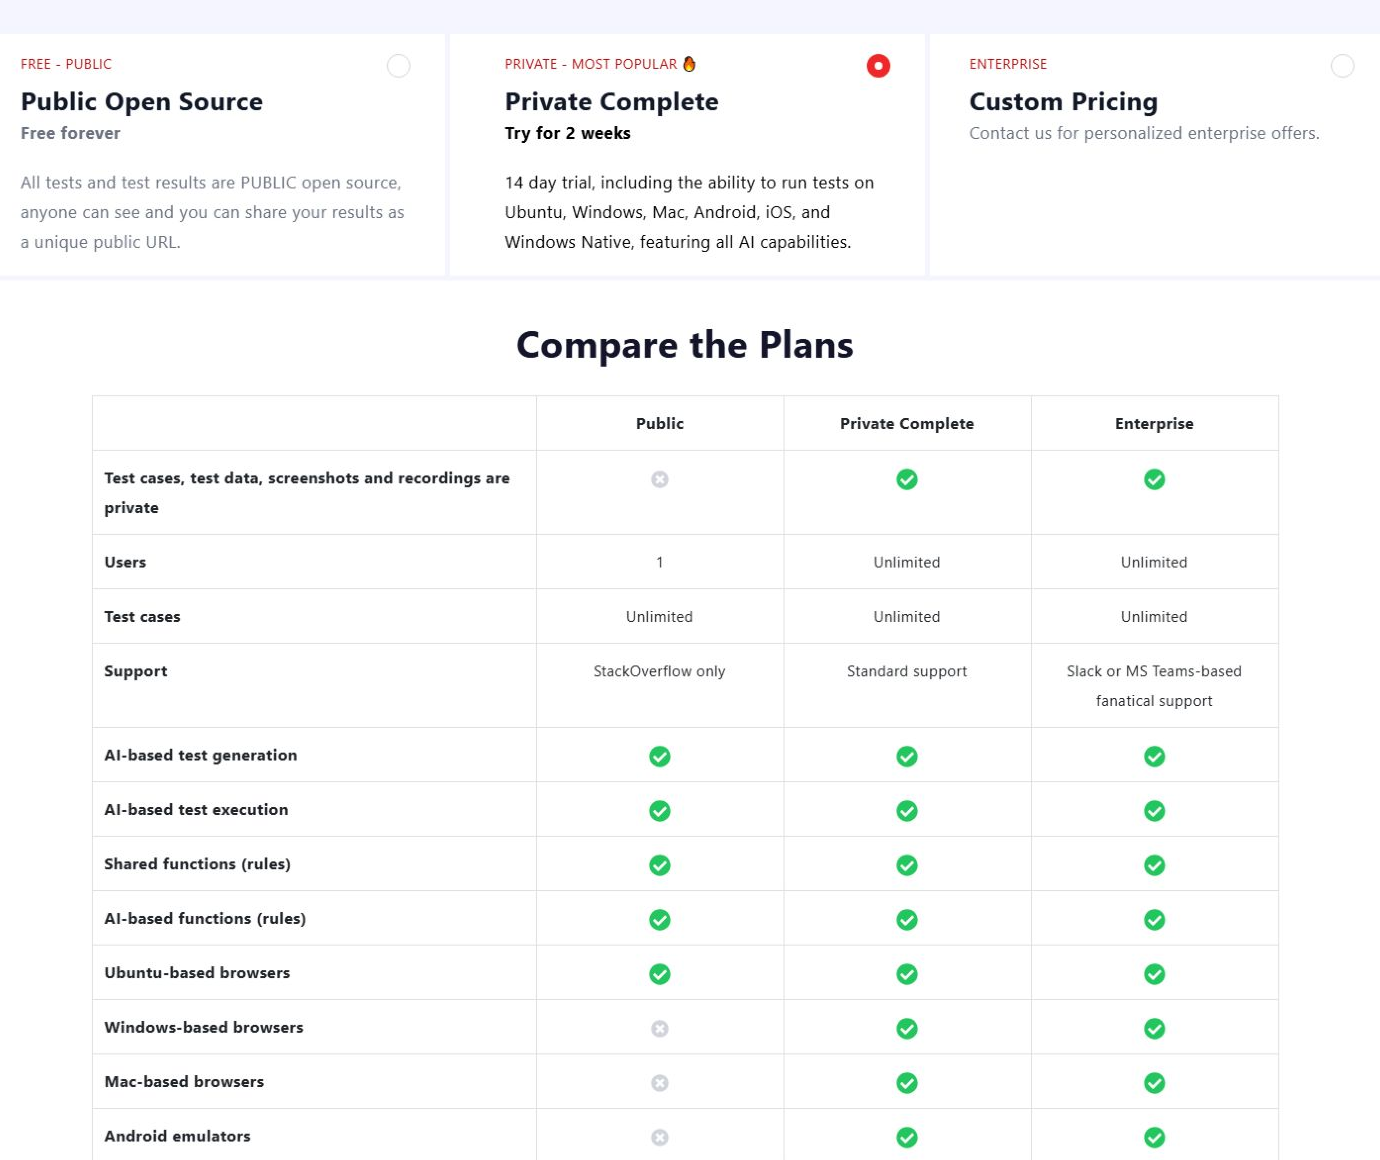
Цены testRigor распределены между несколькими вариантами доступа: Free Public бесплатен; Private Linux Chrome от $300 в месяц с 14-дневным trial; остальные private планы по запросу.
Официальный сайт: https://testrigor.com/
Функционал
- AI-подготовка или поддержка веб-тестов
- Веб-сценарии на plain English с описанием действий и ожидаемых результатов для пользовательских путей на сайте
Ключевые преимущества
- Plain English и no-code/codeless подход позволяют обсуждать сценарий сайта без привязки к синтаксису автоматизации
- AI-based self-healing документирован для поддержки тестов при изменениях элементов интерфейса и требует сверки результата
Сильные стороны
- Документация охватывает web testing и accessibility testing, что полезно для разноплановых проверок интерфейса сайта
- MCP-server guidance и generative-AI testing вынесены в самостоятельные документированные направления для изучения автоматизации
Ограничения
- Публичные тестовые материалы и private workspaces разделены; для закрытого сайта нужно отдельно определить режим доступа
- AI-based self-healing требует сверки после изменений страницы: найденный элемент должен соответствовать ожидаемому действию
Кому подходит
- QA, аналитики и продуктовые команды, которым нужно совместно формулировать веб-сценарии на plain English
- Проекты с регулярной веб-регрессией, где тесты должны оставаться понятными при участии не только автоматизаторов
Тарифы
- Free Public бесплатен
- Private Linux Chrome от $300 в месяц с 14-дневным trial
- остальные private планы по запросу
9. Applitools
Applitools — Visual AI-платформа, сравнивающая внешний вид страниц и компонентов на разных окружениях.
Генерацией работа в Applitools не заканчивается: снять baseline, выполнить тесты в нужных браузерах и просмотреть сгруппированные визуальные различия.
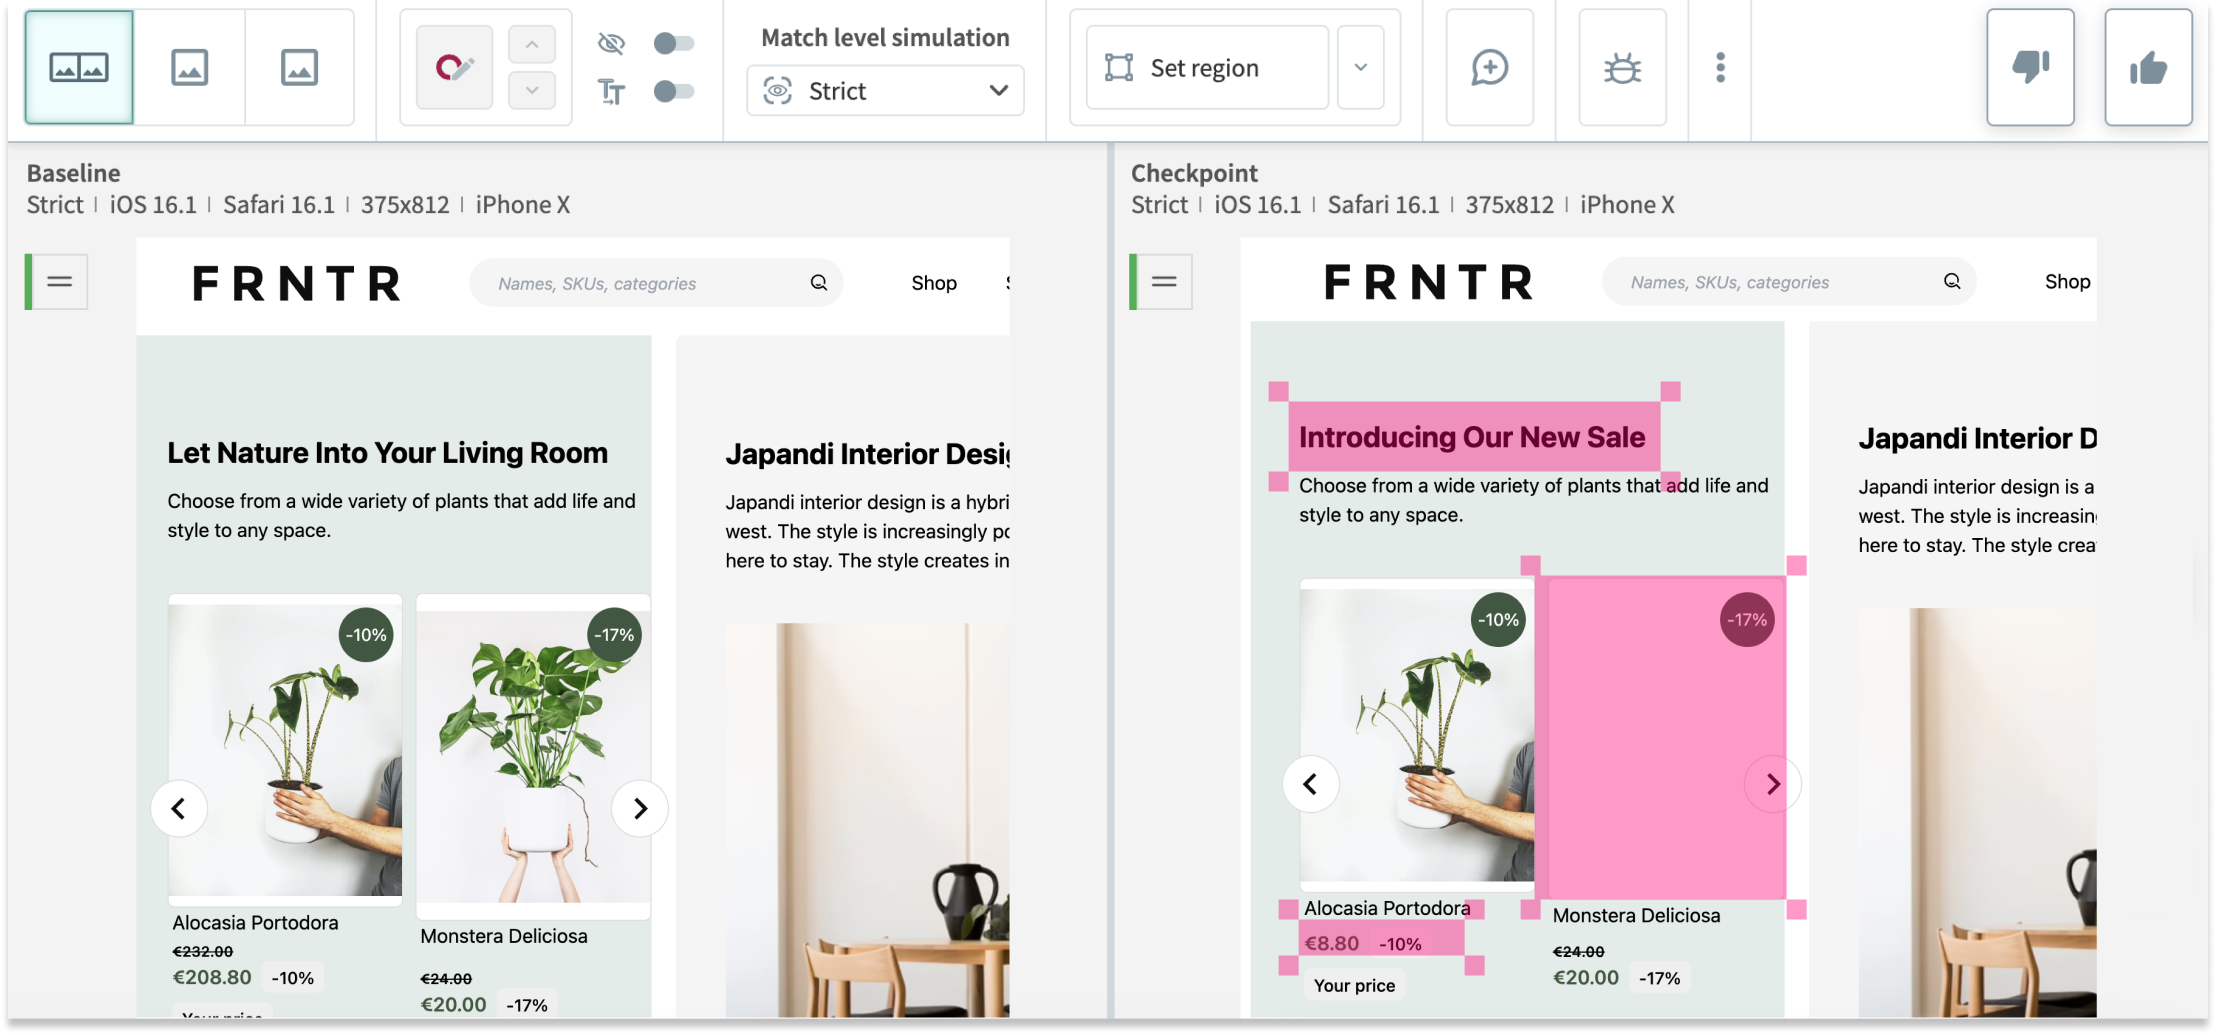
Applitools разумно рассматривать командам, у которых уже есть E2E-тесты и дизайн-система. Eyes добавляет Visual AI к существующему фреймворку, а Ultrafast Grid проверяет интерфейс в разных браузерах и на устройствах. Такой набор полезен, когда после изменения компонента нужно увидеть не только статус сценария, но и расхождение в отображении.
Applitools полезен команде, которая уже автоматизирует сайт в Cypress или другом фреймворке и хочет отдельно контролировать визуальные изменения. Eyes добавляет Visual AI к существующим тестам, а Ultrafast Grid помогает проверить интерфейс в разных браузерах и на устройствах. Функциональные сценарии при этом остаются отдельной задачей.
Смысл Applitools — не в замене всего QA-набора, а в добавлении визуальных проверок к существующей автоматизации. Eyes умеет работать рядом с текущим тестовым фреймворком, а платформа также документирует end-to-end функциональные и API-тесты. Для сайта это позволяет разнести проверку поведения, ответов API и внешнего вида по подходящим уровням тестирования.
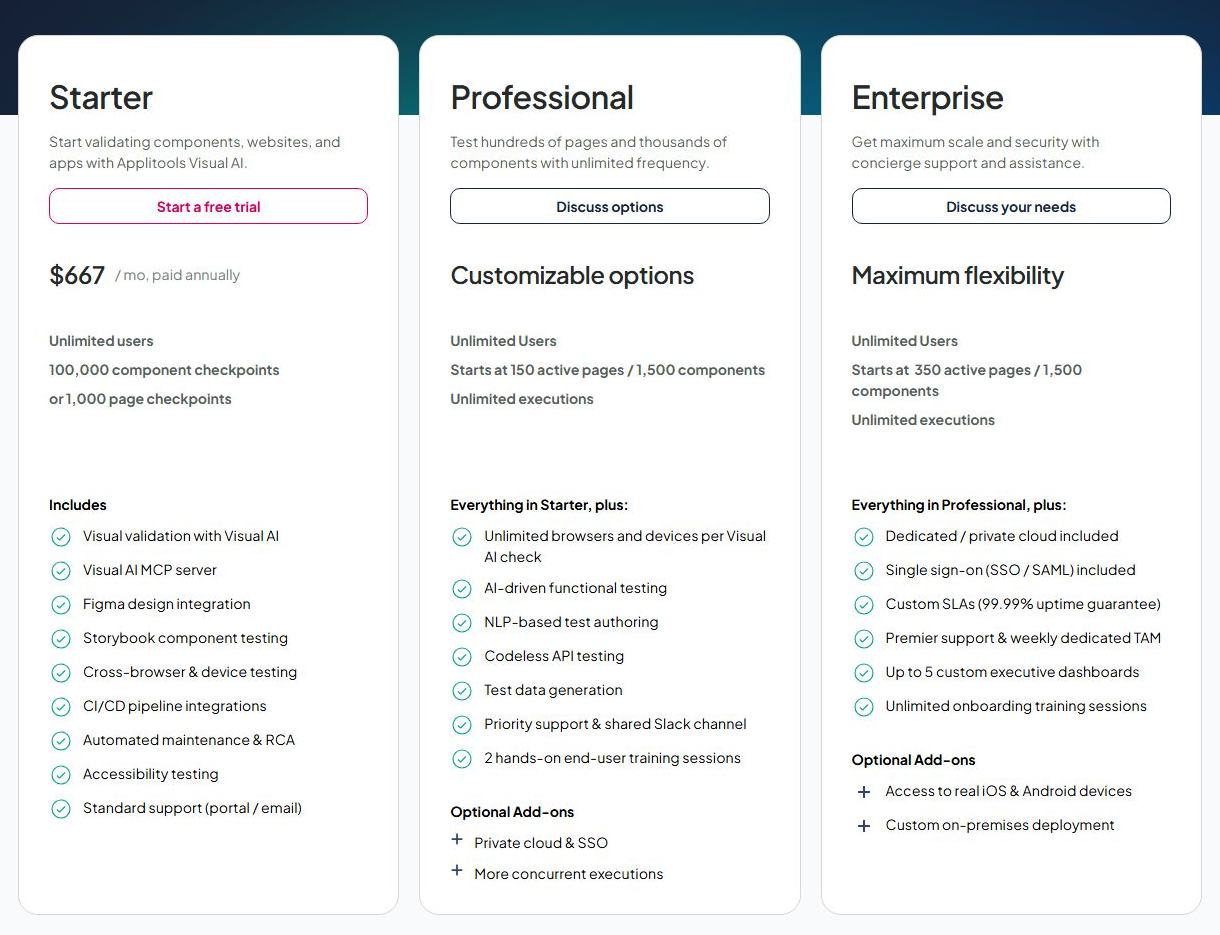
Коммерческая модель Applitools на дату проверки выглядит так: доступен free trial; Starter стоит $667 в месяц при годовой оплате и включает 100 000 component checkpoints или 1 000 page checkpoints. Professional и Enterprise рассчитываются по запросу: Professional начинается от 150 активных страниц или 1 500 компонентов, Enterprise — от 350 активных страниц или 1 500 компонентов.
Практический сценарий для Applitools начинается с уже работающего E2E-теста: в него добавляют Eyes, задают визуальные контрольные точки и запускают проверку через Ultrafast Grid. Затем команда разбирает найденные расхождения вместе с обычным результатом сценария. Это подходит для регулярных изменений интерфейса, но не освобождает от проверок логики и API.
Официальный сайт: https://applitools.com/solutions/visual-testing/
Функционал
- AI-подготовка или поддержка веб-тестов
- Ultrafast Grid выполняет визуальные проверки в разных браузерах и на устройствах, чтобы сравнить отображение интерфейса после изменения верстки.
Ключевые преимущества
- Eyes добавляет Visual AI к существующему тестовому фреймворку, поэтому визуальные проверки не требуют переноса всей автоматизации в новый инструмент.
- SDK позволяют добавить визуальные assertions к уже написанным E2E-сценариям и не переносить существующую автоматизацию в отдельный тестовый контур.
Сильные стороны
- Applitools документирует end-to-end функциональные, визуальные и API-тесты, поэтому проверки поведения и внешнего вида можно вести в одной платформе.
- Eyes работает с сайтами, приложениями и документами, что расширяет область визуальных сравнений за пределы одной браузерной страницы.
Ограничения
- Visual AI оценивает внешний вид; для бизнес-логики, API-ответов и пользовательских условий нужны отдельные функциональные assertions.
- TestGenAI генерирует self-healing Cypress-тесты, но сгенерированные сценарии нужно соотносить с фактическими условиями и ожидаемым поведением конкретного сайта.
Кому подходит
- Команды с дизайн-системой, которым нужно отслеживать расхождения компонентов в нескольких браузерах и на устройствах.
- Веб-проекты, где E2E-тесты уже есть и им требуется отдельный слой визуальных сравнений интерфейса.
Тарифы
- Free trial — доступен через регистрацию; срок пробного доступа не указан на проверенной странице.
- Starter — $667 в месяц при годовой оплате: неограниченное число пользователей, 100 000 component checkpoints или 1 000 page checkpoints.
- Professional — стоимость по запросу: от 150 активных страниц или 1 500 компонентов, неограниченные пользователи и запуски.
- Enterprise — стоимость по запросу: от 350 активных страниц или 1 500 компонентов, неограниченные пользователи и запуски.
10. SmartBear Reflect
SmartBear Reflect — AI-assisted no-code инструмент для браузерных сценариев, входящий в портфель SmartBear.
Для веб-тестирования аргумент в пользу SmartBear Reflect сформулирован довольно ясно: быстро переводит ручной smoke-flow в повторяемую автоматизацию.
SmartBear Reflect стоит рассматривать небольшим QA- и продуктовым командам, которым нужно фиксировать повторяющиеся веб-потоки в управляемом наборе тестов. В документации есть запись тестов, их повторная запись и редактирование, переменные и параметры, а также папки и suites для организации набора. Такой подход особенно понятен там, где регрессию проводят регулярно.
Рабочий поток в Reflect можно построить так: записать пользовательский сценарий, отредактировать шаги или перезаписать тест после изменения экрана, затем включить его в нужную папку или suite. Если один и тот же путь проверяют с разными данными, используются переменные и параметры. Для визуального состояния предусмотрены отдельные проверки.
В Reflect запись сценария не заканчивается первым прогоном: тест можно переснять, разложить по папкам и объединить в suites. Это удобно для сайта с повторяющимися пользовательскими маршрутами, где команда поддерживает набор проверок по разделам, а не ищет каждый сценарий в одном общем списке.
Reflect стоит оценивать по тому, какие слои сайта предстоит проверять. Платформа документирует visual-state проверки, переменные и параметры, а также API- и email/SMS-тесты. Для команды это означает, что запись браузерного маршрута может стать только частью сценария: связанные проверки потребуют отдельной структуры и настройки.
Reflect целесообразно оценивать по тому, как он ведет конкретный повторяющийся поток после изменения интерфейса. Сервис позволяет записать тест, отредактировать или перезаписать его, а затем собрать тесты в папки и suites. Для сценариев с меняющимися данными пригодятся переменные и параметры; отдельно документированы API- и email/SMS-тесты.
Официальный сайт: https://reflect.run/reflect-app
Функционал
- AI-подготовка или поддержка веб-тестов
- Тесты можно редактировать и перезаписывать, а папки и suites помогают собирать повторяющиеся проверки в управляемый набор.
Ключевые преимущества
- Запись теста сокращает путь от повторяющегося пользовательского потока к воспроизводимой проверке, которую затем можно редактировать.
- Переменные и параметры позволяют использовать один тест с разными входными данными, не дублируя одинаковые шаги для каждого случая.
Сильные стороны
- Reflect документирует визуальные состояния, API, email/SMS и private или local environments — полезно, когда веб-поток зависит от окружения.
- Developer API и SmartBear MCP расширяют варианты интеграции Reflect с внешними инструментами и агентными рабочими процессами.
Ограничения
- Записанный тест всё равно нужно обновлять или перезаписывать при существенном изменении пользовательского потока либо состояния интерфейса.
- API-, email/SMS- и визуальные проверки имеют разные входные условия, поэтому их не стоит сводить к одному записанному браузерному сценарию.
Кому подходит
- Небольшие QA- и продуктовые команды, которым нужно записывать, редактировать и регулярно повторять ключевые веб-потоки.
- Проекты, где вместе с браузерными сценариями требуется проверять visual state, API либо email- и SMS-уведомления.
Тарифы
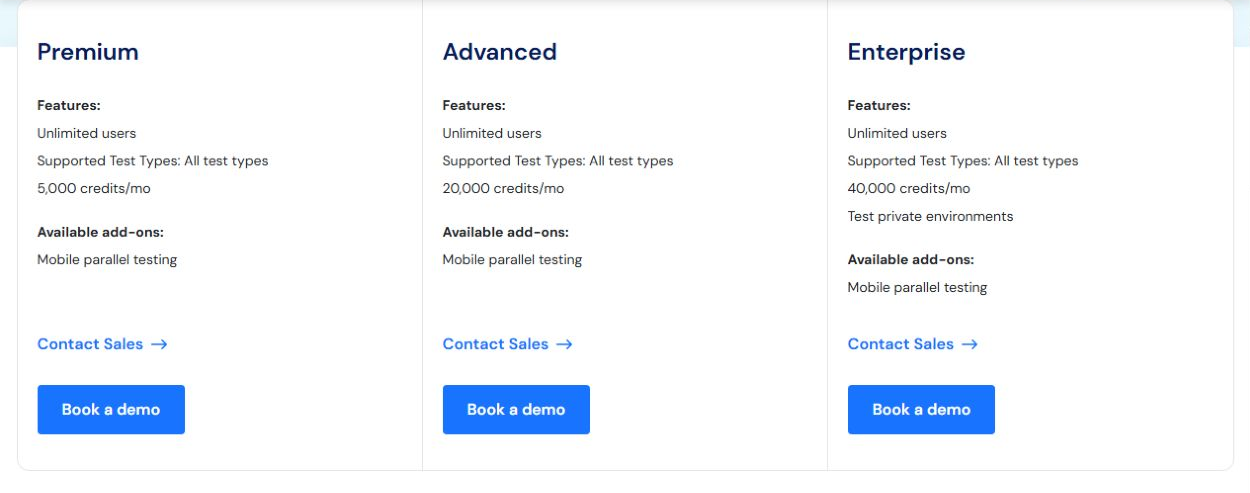
- trial 14 дней с unlimited functionality
- Premium 5 000, Advanced 20 000, Enterprise 40 000 credits в месяц, цены по запросу
Итоги
Testim и mabl подходят зрелому непрерывному тестированию, KaneAI и BrowserStack — командам, которым важно облако браузеров, Functionize и Autify дают понятный AI-first старт. Для plain-English сценариев стоит проверить testRigor или Reflect, а визуальные регрессии лучше всего раскрывают Applitools. Пилот с реальными падениями остаётся обязательным.